Data Reduction Ratio (Relación de Reducción de Datos)
Datos lógicos (lo que los sistemas creen que almacenan)
vs
Datos físicos (lo que realmente ocupa espacio en el arreglo)
Es decir es una métrica que indica cuánto se logró reducir el espacio físico necesario para almacenar una determinada cantidad de datos lógicos.
La relación se expresa normalmente así:
Data Reduction Ratio = Datos lógicos/ Datos físicos consumidos.
Ejemplo:
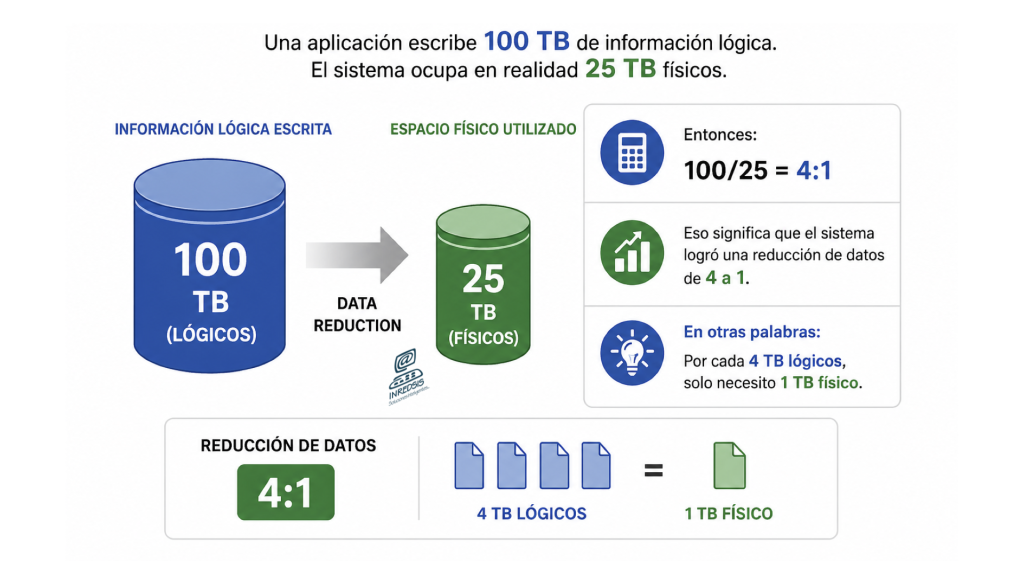
Una aplicación escribe 100 TB de información lógica.
El sistema ocupa en realidad 25 TB físicos.
Entonces:
100/25 = 4:1
Eso significa que el sistema logró una reducción de datos de 4 a 1.
En otras palabras:
Por cada 4 TB lógicos, solo necesito 1 TB físico.
Diferencia entre datos lógicos y datos físicos
Datos lógicos
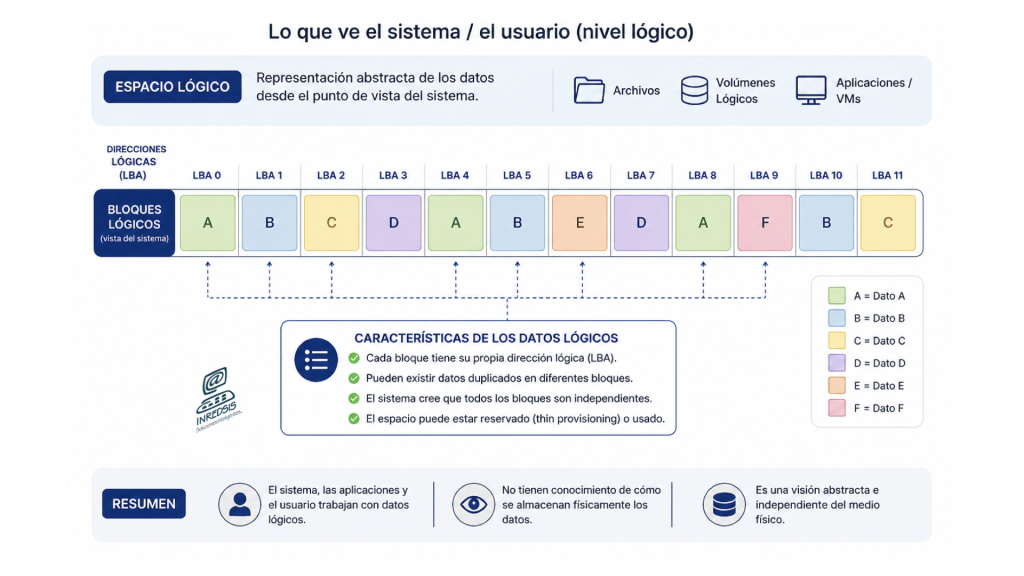
Son los datos vistos por el host, sistema operativo, hipervisor o aplicación.
Ejemplo: Un servidor puede ver que tiene un almacenamiento de 50 TB.
Datos físicos
Es el espacio real consumido en el arreglo o sistema de almacenamiento después de aplicar reducción.
Ejemplo:
Esos mismos 50 TB lógicos pueden estar ocupando 12 TB físicos.
¿Para qué sirve el Data Reduction Ratio?
1. Medir eficiencia del almacenamiento
Permite saber si el sistema está aprovechando de manera correcta la capacidad instalada.
2. Estimar crecimiento real.
No es suficiente saber cuánto dato lógico generan las aplicaciones.
También importa cuánto terminará ocupando físicamente.
3. Optimización de capacidad
Permite saber cuánto espacio estás ahorrando realmente.
- Sin DDR: necesitas 100 TB físicos.
- Con DDR 5:1 solo necesitas 20 TB.
4. Comparar comportamiento de cargas de trabajo
Dos ambientes con la misma cantidad de datos lógicos pueden consumir espacios físicos distintitos.
¿Cómo se logra el Data Reduction Ratio?
EL Data Reduction Ratio (DDR) es el resultado combinado de:
- Compresión
- Deduplicación
- Thin provisioning (en algunos casos)
Compresión
La compresión transforma los datos para que ocupen menos espacio sin perder información (lossless).
Conceptualmente :
Convierte esto:
AAAAAAAAAABBBBBBCCCCCCCCCC
En algo como:
7A5B6C
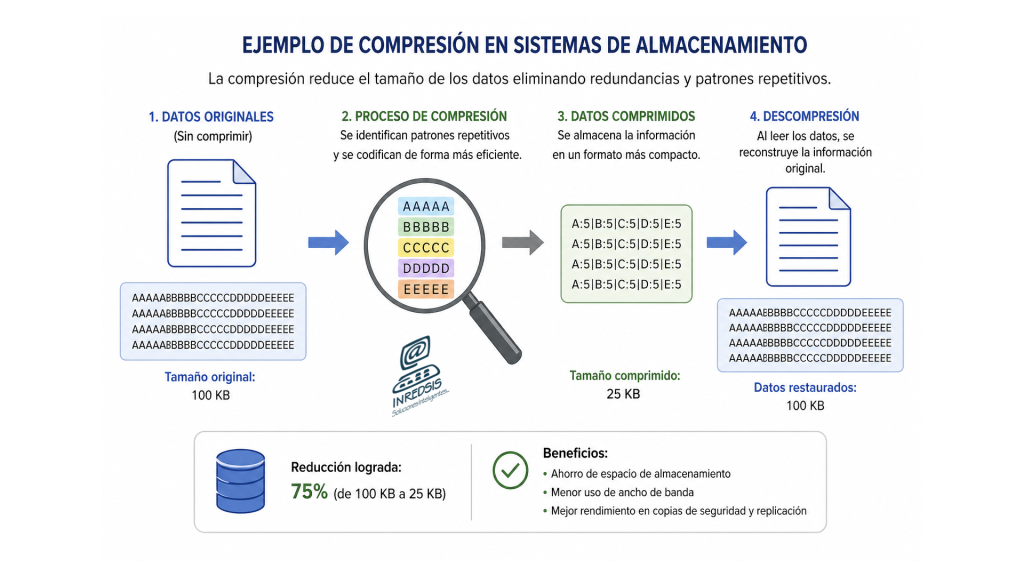
Pero en almacenamiento real es mucho más complejo.
¿Cómo funciona técnicamente?
En sistemas modernos (ejemplo all-flash), la compresión es parte de un flujo de trabajo:
1. El dato entra al sistema (write I/O).
La entrada de datos es el momento en que un sistema origen solicita al almacenamiento que guarde la información.
¿Qué significa Write I/O?
Write I/O significa operación de escritura de entrada/salida.
- Ocurre cuando:
- Un servidor guarda un archivo,
- Una base de datos inserta o actualiza registros,
- Una máquina virtual escribe en su disco virtual,
- Una aplicación genera logs.
- Un usuario copia información a un arreglo de almacenamiento, NAS o SAN.
En otras palabras , el host le dice al sistema de almacenamiento:
“Guarda estos datos”
¿Qué elementos participan en esta etapa?
- Aplicación: genera el dato.
- Sistema operativo: convierte la solicitud en operaciones de escritura.
- Sistema de archivos o gestor de volúmenes: organiza cómo se va a presenta es escritura.
- Controlador de almacenamiento: recibe la solicitud.
- Red de almacenamiento: se encarga del transporte de la información, por ejemplo FC, iSCSI, NFS, SMB o NVMe-oF.
Aunque pensemos que “se guarda un archivo”, el almacenamiento normalmente no ve el archivo como tal.
Lo que ve son.
- Bloques.
- Páginas
- Segmentos.
- Secuencias de bytes.
Por ejemplo, si un usuario guarda un documento de Word de 20 MB, el sistema de almacenamiento no necesariamente “entiende Word”, lo que recibe son múltiples operaciones de escritura con ciertos tamaños y en cuántas unidades (bytes, bits, posiciones, etc.) se mueve desde un inicio para llegar a un dato específico.
¿Qué ocurre al llegar el dato?
Cuando llega el Write I/O, el sistema debe:
- Recibir la solicitud.
- Validar permisos y rutas.
- Identificar a qué volumen (filesystem)/share (NAS)/LUN (bloque SAN)/ Disco físico/Arreglo.
- Ubicar en que espacio lógico debe colocarse.
- Pasar el dato al proceso interno de optimización.
En sistemas modernos, el dato rara vez se escribe directamente al medio final sin tratamiento previo. Antes puede pasar por:
- Caché.
- Memoria NVRAM p MVDIMM.
- Cola de escritura.
- Motores de deduplicación.
- Validación de integridad.
- Importancia de la fase de compresión
Esta fase determina:
- La latencia inicial de escritura.
- La cantidad de operaciones por segundo.
- La consistencia del dato.
- La eficiencia de todo el proceso.
Si la entrada de datos es desordenada, muy aleatoria o con bloques muy pequeños, puede afectar el rendimiento y la eficiencia de la compresión.
2. Se divide en bloques (ejemplo 4K, 8K, 16K).
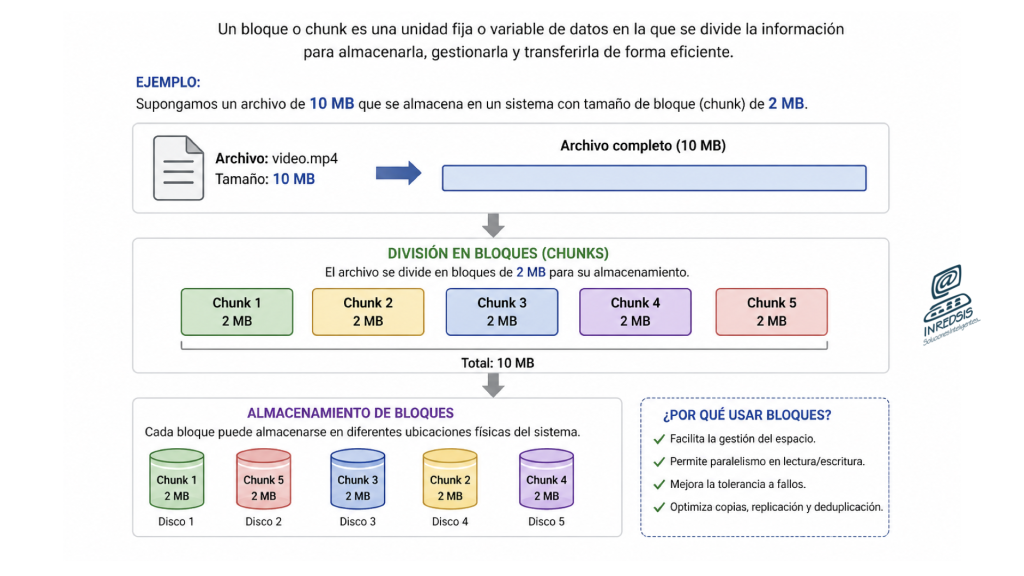
Una vez que los datos entran, el sistema normalmente los divide u organiza en unidades manejables llamadas bloques.
¿Qué es un bloque (chunk)?
Un bloque es una unidad lógica de almacenamiento.
Es el tamaña mínimo o estándar con el que el sistema manipula datos internamente.
Ejemplos comunes:
- 4 KB
- 8 KB
- 16 KB
- 32 KB
- Tamaños variables en algunos sistemas avanzados.
¿Por qué se segmenta?
Porque el almacenamiento necesita trabajar con unidades uniformes o controladas para poder:
- Localizar datos.
- Moverlos.
- Compararlos.
- Deduplicarlos.
- Comprimirlos.
- Replicarlos
- Protegerlos con paridad o metadatos.
Sin segmentación, un flujo continuo de bytes sería muy difícil de administrar eficientemente.
Ejemplo conceptual
Supongamos que una aplicación escribe a 64 KB.
El sistema podría segmentarlo de la siguiente forma:
- 16 bloques de 4 KB
- 8 bloques de 8 KB
- 4 bloques de 16 KB
Cada bloque puede ser tratado individualmente.
¿Por qué importa el tamaño del bloque?
El tamaño del bloque afecta muchas cosas.
Bloques pequeños
Ventajas:
- Mayor granularidad: es posible trabajar con porciones más pequeñas de datos.
- Mejor aprovechamiento del espacio: menos espacio muerto dentro de cada bloque.
- Mejor deduplicación fina: la deduplicación compara bloques, con bloques grandes, dos archivos similares pero con pequeñas diferencias no deduplican. Con bloque pequeños, solo cambian algunos bloques y el resto se deduplica.
- Mejor compresión selectiva: se puede aplicar compresión donde realmente vale la pena.
- Menos desperdicio cuando los cambios son pequeños.
Desventajas:
- Más metadatos: consume RAM y CPU y aumenta complejidad del sistema.
- Más trabajo administrativo: el sistema tiene que manjar más entradas en tablas, más índices y más operaciones de lookup.
- Más carga sobre CPU/controladores: cada bloque implica, más cálculos de deduplicación, compresión y gestión de metadatos.
Bloques grandes
Ventajas:
- Menos metadatos: utiliza menos RAM, menor carga de CPU y es menor la complejidad del sistema.
- Administración más simple: menos bloques = menos objetos que gestionar.
- Mejor para flujos secuenciales grandes: es más eficiente para backups grandes, video (streaming, CCTV), replicación , copias de VM completas, etc.
Desventajas:
- Menor granularidad: se pierde precisión en el manejo de datos, ya que se requiere de más escritura y más consumo de recursos.
- Más desperdicio si solo cambia una pequeña parte: hay más desperdicio de I/O (entradas y salidas) y espacio.
- Puede bajar la eficiencia de reducción de datos: la eficiencia de compresión baja considerablemente.
Segmentación fija vs variable
Segmentación fija
Todos los bloques tienen el mismo tamaño.
Ejemplo:
- Todo se divide en 4 KB exactos.
Ventajas:
- Simple
- Rápida
- Fácil de indexar
Desventajas:
- En ocasiones no captura de forma adecuada patrones que “ se mueven”.
Segmentación variable
El sistema corta según contenido, no solo por tamaño fijo.
Ventajas:
- Mejor para encontrar redundancia cuando los datos cambian de posición.
- Puede mejorar la deduplicación y compresión.
Desventajas:
- Más compleja.
- Más costosa computacionalmente.
Relación con el rendimiento
La segmentación es importante porque define la unidad sobre la cual operarán las siguientes fases. Si el sistema segmenta mal los datos, los mecanismos de detección de patrones y compresión serán menos eficientes.
3. Se procesa con algoritmos de compresión.
Cada bloque de datos pasa por un proceso matemático que intenta reducir su tamaño antes de almacenarlo.
El sistema toma un bloque y:
- Analiza el contenido.
- Detecta patrones repetidos.
- Reemplaza esos patrones por representaciones más cortas.
¿Qué es un patrón?
Un patrón es una secuencia de datos que aparece repetidamente o que tienen una estructura predecible.
Ejemplos conceptuales:
- Cadenas repetidas.
- Ceros consecutivos.
- Estructuras similares.
- Encabezados repetidos.
- Registros con formato constante.
- Contenido similar entre bloques.
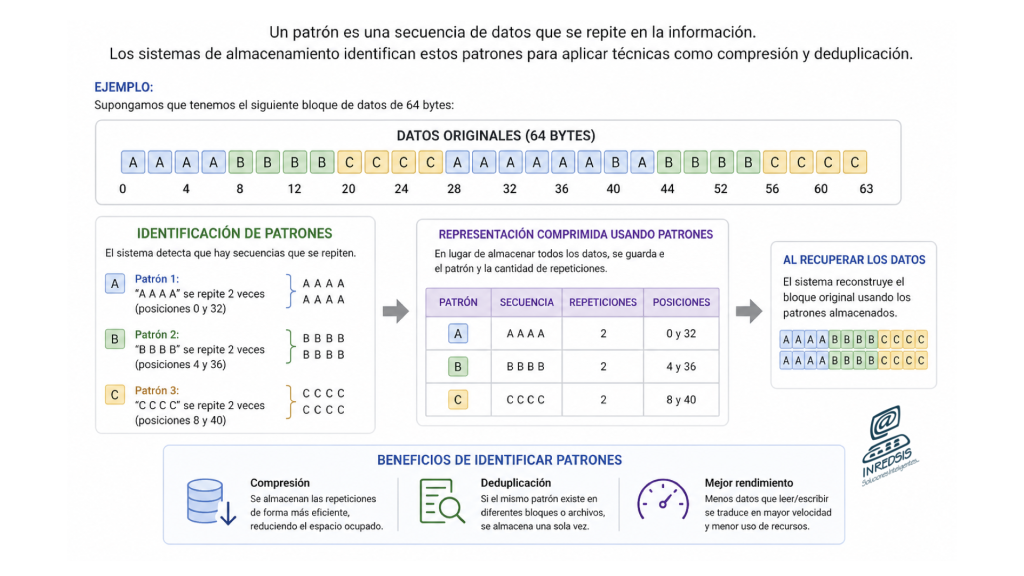
¿Por qué se buscan patrones?
Porque la compresión solo funciona bien si el sistema encuentra algo que pueda representar de forma más corta.
Si un bloque contiene mucha repetición, entonces puede almacenarse de manera más eficiente.
Tipos de patrones que puede detectar el sistema
Repetición literal
Ejemplo conceptual:
AAAAAA
BBBBBBB
000000
Secuencias repetidas
Ejemplo:
ABCDEFABCDEFABCDEF
Campos estructurados repetitivos
Muy común en:
- Bases de datos.
- Logs.
- Archivos de texto.
- Máquinas virtuales con sistemas operativos similares.
Regiones vacías o llenas de ceros
Esto ocurre mucho en:
- Discos virtuales.
- Archivos preasignados.
- Bloques no utilizados.
Similitud entre bloques
Aunque no sean idénticos, algunos bloques comparten gran parte de su contenido.
¿Cómo un sistema de almacenamiento detecta esos patrones?
Generalmente utiliza una combinación de:
- Comparación de secuencias.
- Tablas de referencia.
- Diccionarios.
- Hashes que es el resultado de aplicar una función matemática a un dato para generar un valor único de tamaño fijo que lo representa.
- Análisis estadístico.
- Ventanas deslizantes.
Ventanas deslizantes
Una técnica común consiste en analizar fragmentos del bloque avanzando poco a poco, buscando coincidencias con fragmentos anteriores.
Esto permite detectar repeticiones incluso si no están exactamente alineadas.
Hashing
El sistema puede generar una “huella digital” del contenido de un bloque o sub-bloque. Si dos huellas coinciden, hay alta probabilidad de que el contenido sea igual o similar.
Esto se utiliza para:
- Deduplicación.
- Identificación rápida de redundancia.
- Acelerar búsquedas en tablas internas.
Diccionarios
El sistema puede construir una tabla interna de secuencias frecuentes.
Cuando detecta una repetición, en lugar de almacenar la secuencia completa, guarda una referencia al diccionario.
Entropía
También puede estimarse cuán “aleatorio” es un bloque.
- Baja entropía: muy repetitivo, muy comprimible.
- Alta entropía: muy aleatorio, difícil de comprimir.
Archivos ya comprimidos o cifrados suelen tener alta entropía.
Resultados de esta fase
Al terminar, el sistema ya sabe cosas como:
- Qué partes se repiten.
- Cuáles son candidatas a compresión.
- Cuáles quizá no conviene comprimir,
- Qué método puede ser más eficiente.
Esta fase es el puente entre recibir datos y transformarlos inteligentemente.
4. Se almacena comprimido.
Después de que el bloque de datos fue procesado por el algoritmo de compresión, el sistema escribe en el medio físico la versión comprimida y no la versión original completa.
El dato lógico sigue siendo el mismo para el usuario o la aplicación, pero físicamente ocupa menos espacio.
Como funciona este proceso:
Ya existe un bloque transformado.
Antes de llegar a esta fase, el sistema ya tomó un bloque original, por ejemplo de 4 KB, 8 Kb o más, y lo pasó por un algoritmo de compresión.
Ejemplo conceptual:
- Bloque original: 8 KB.
- Después de compresión: 3 KB.
Es esta etapa, el sistema decide guardar esos 3 KB útiles, junto con la información necesaria para poder reconstruir el bloque original cuando se lea.
El sistema asigna espacio físico real
El almacenamiento necesita decidir dónde va a vivir ese bloque comprimido.
Eso implica:
- Reservar espacio físico en SSD, NVMe o disco.
- Apuntar ese bloque a una ubicación física.
- Registrar cuánto mide realmente comprimido.
- Asociarlo con su referencia lógica original.
Aquí hay una diferencia importante:
- Tamaño lógico: lo que la aplicación cree haber escrito.
- Tamaño físico: lo que realmente se guardó tras comprimir.
Ejemplo:
- La VM escribe a 8KB.
- El array solo consume 3 KB físicos.
Se guardan metadatos para poder reconstruirlo
Esto es esencial. No es suficiente con guardar el bloque comprimido. El sistema también necesita guardar metadatos que indiquen cosas como:
- Que ese bloque está comprimido.
- Qué algoritmo se usó.
- Cuál era su tamaño lógico original.
- Dónde empieza y termina la versión comprimida.
- A qué volumen, LUN, página o estructura pertenece.
- Si tiene referencia compartida con otros bloques.
Sin esos metadatos, el sistema no sabría cómo leer correctamente el dato después.
La versión comprimida se vuelve la “verdad física”
Una vez que hay una escritura, la copia comprimida se convierte en la representación real del dato dentro del almacenamiento.
Eso significa que cuando más adelante alguien lea ese dato, el flujo será:
Lectura física del bloque comprimido – descompresión – entrega del dato original.
La aplicación nunca ve el dato comprimido, La aplicación recibe el dato reconstruido, transparente para ella.
Qué guarda realmente el sistema
- En términos prácticos, el sistema no guarda solamente “el bloque comprimido”, aislado. Normalmente guarda un conjunto de elementos:
- Payload comprimido: es el contenido reducido, el bloque comprimido en sí.
- Metadatos de compresión: Es la información de control para saber cómo manejar ese bloque.
- Punteros o referencias: Es la relación entre la dirección lógica del dato y su ubicación física.
- Información de integridad: Es el conjunto de mecanismos que utiliza un sistema de almacenamiento para garantizar que los datos se mantengan exactamente iguales a como fueron escritos, sin corrupción, alteraciones o errores
5. Se escribe en disco
Una vez que el dato fue recibido, segmentado, analizado y posiblemente comprimido, llega la fase de persistencia física.
¿Qué significa escribir en disco?
Significa guardar de manera durable la información en el medio de almacenamiento:
- SSD (Solid State Dive o Unidad de Estado Solido): se basa en memoria flash, sin partes mecánicas, es rápido y es de uso empresarial actual.
- NVMe: es de tipo SSD, pero mucho más rápida y se conecta directamente al bus PCIe, su latencia es de microsegundos.
- HDD (Hard Disk Drive o Disco Duro): es un disco mecánico. Es lento, pero más barato por TB.
- algún medio persistente equivalente: pueden ser almacenamientos distribuidos, almacenamiento en red (NAS/SAN), NVRAM/SCM en sistemas avanzados.
En este punto el dato deja de estar solo “en tránsito” o “en cache temporal” y pasa a quedar almacenado con persistencia.
¿Se escribe exactamente como llego?
Generalmente no.
Lo que se escribe puede incluir:
- Bloque comprimido: es el dato original pero reducido mediante algoritmos de compresión.
- Referencias a diccionarios: en lugar de guardar datos repetido, guarda una referencia a un patrón ya existente.
- Metadatos: son datos sobre los datos, incluyen tamaño, tipo, ubicación lógica, estado (activo, snapshot, borrado), propietario, timestamps.
- Checksum (Integridad): valida que el bloque no se corrompió.
- Información de ubicación: indica dónde está físicamente el dato.
- Mapas lógicos-físicos: son las tablas que relacionan la dirección lógica (lo que pide el servidor) y la dirección física (dónde está realmente).
- Punteros a snapshots o a estructuras de protección: un snapshot es una foto lógica de los datos en un momento dado, no se copia todo, solo se guardan referencias a bloques existentes.
Es decir, el sistema no solo escribe “contenido”; también escribe la información necesaria para poder:
- Encontrarlo.
- Validarlo.
- Reconstruirlo.
- Replicarlo.
- Borrarlo.
- Reutilizarlo.
Escritura lógica vs física
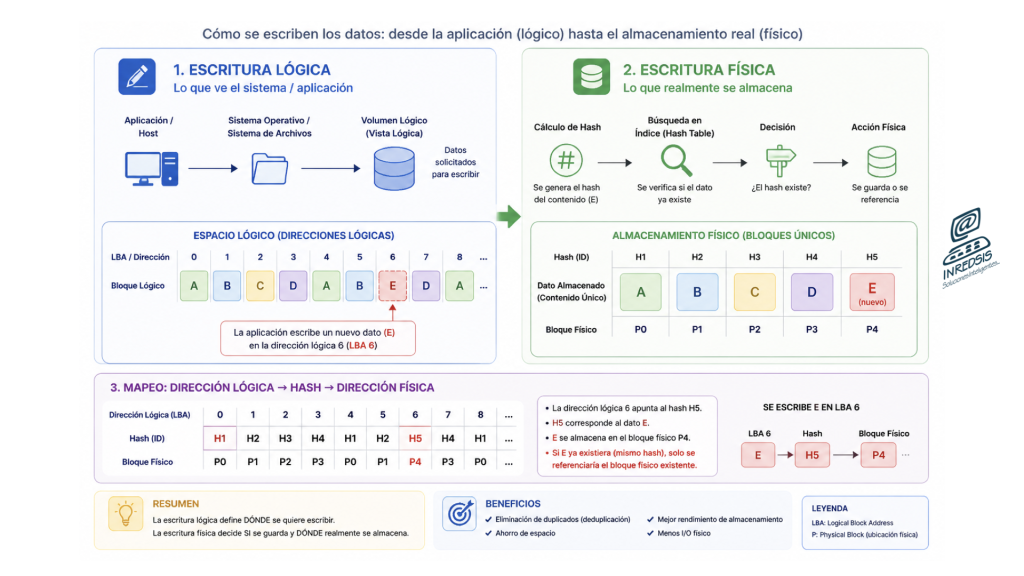
Escritura lógica
Es la visión del host o aplicación.
Ejemplo:
- Escribe a 8KB en el offset o posición dentro de un espacio lógico de datso X: Significa que el sistema va a guardar (writ I/O) un bloque de datos de tamaño de 8 KB que es igual a 8,192 bytes, y que no es un archivo completo, sino un fragmento específico de datos.
Escritura física
- Es cómo el sistema realmente lo guarda internamente.
- Moverlo a otra ubicación
- Agrupar varios bloques
- Escribir comprimido
- Registrar metadatos en otra zona
- Distribuirlo entre varios dispositivos
Papel de la caché o memoria rápida temporal y protección contra fallos.
Antes de confirmar que la escritura fue exitosa, muchos sistemas usan:
- Caché protegido
- Memoria no volátil
- Journal (bitácora)
- Registro transaccional
- Espejo entre controladoras
Esto permite que, aunque se corte la energía, el sistema no pierde la consistencia del dato que ya había aceptado.
Confirmación de escritura
Normalmente el almacenamiento responde al host con algo equivalente a:
“La escritura fue aceptada y protegida”
Dependiendo de la arquitectura, esto puede significar:
- Ya está en disco.
- Ya está en memoria no volátil segura.
- Ya está replicada en otro controlador
- Ya quedo registrada para persistirse sin pérdida.
Metadatos en esta fase
El sistema debe guardar información como:
- Dirección lógica del bloque.
- Ubicación física real.
- Tamaño.
- Estado de compresión.
- Checksum
- Referencias de snapshot.
- Versión del bloque.
- Relación con otras estructuras del sistema.
Impacto en SSD y flash
En sistemas flash, escribir en disco no significa lo mismo que en discos duros tradicionales.
La flash tiene características como:
- Páginas y bloques de borrado: la memoria flash esta organizada en dos niveles, página que es la unidad mínima de escritura y bloque que es el conjunto de páginas.
- Garbage collection: es el proceso que limpia bloques parcialmente usados y recupera espacios inválidos.
- Wear leveling: que distribuye las escrituras uniformemente en toda la memoria.
- Write amplification: es cuando el sistema escribe más datos de los que el host pidió.
Por eso muchos sistemas optimizan la escritura para:
- Escribir menos veces.
- Escribir de forma alineada.
- Reducir escrituras.
- Prolongar la vida útil de la flash.
La compresión ayuda aquí porque reduce la cantidad de datos físicos que realmente deben programarse en la memoria flash.
Por eso una escritura lógica no siempre equivale a una única escritura física simple.
Esto puede ocurrir en tiempo real (inline) o después de escribir (post-process).
Deduplicación
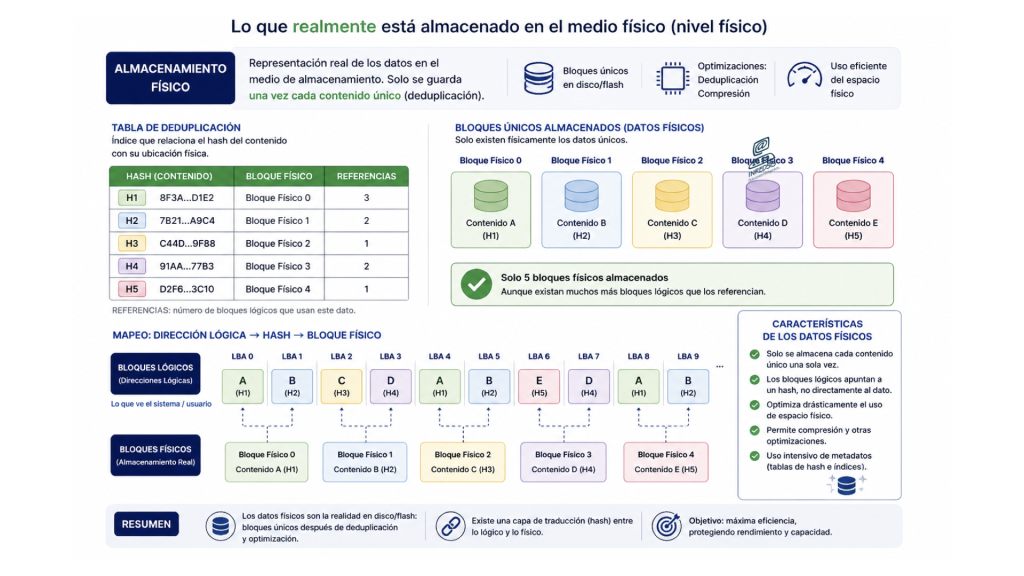
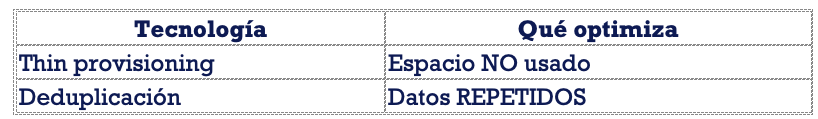
Es una técnica que elimina datos duplicados para ahorrar espacio. En lugar de almacenar múltiples copias idénticas de la misma información, el sistema guarda una sola copia y crea referencias para las demás.
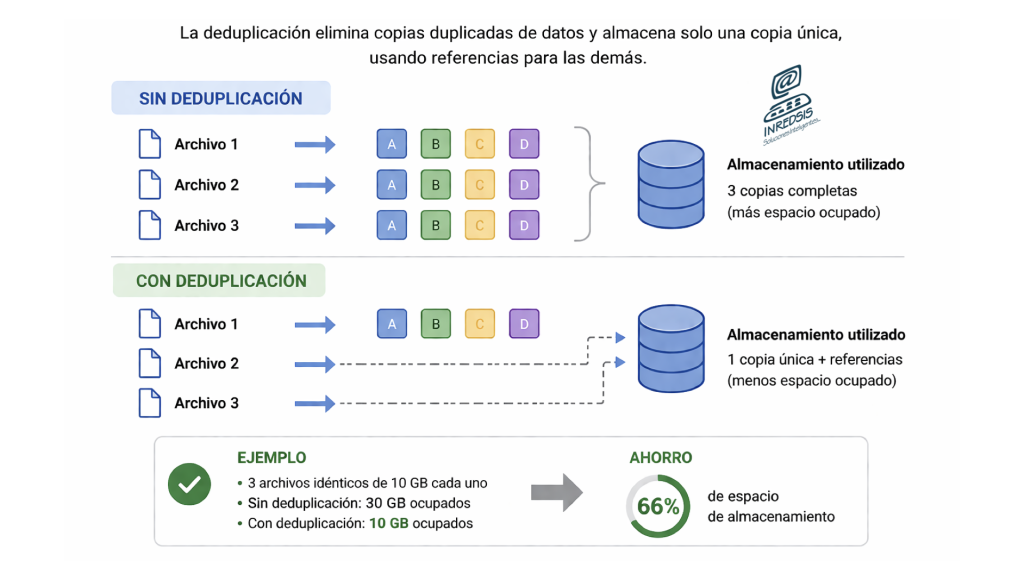
Modelo conceptual
Modelo tradicional: Dirección → Dato
En almacenamiento clásico (discos, SAN, archivos):
Dirección (LBA / offset) → Dato
Significa:
- Cada dirección apunta directamente a un contenido específico.
- Si lees esa dirección, obtienes exactamente ese dato.
- Si escribes ahí, sobrescribes ese dato.
Nota:
En almacenamiento, una dirección es simplemente una posición física o lógica donde se guarda información.
Hay dos formas de expresarla:
- LBA (Logical Block Address) que es el número de bloque lógico en un disco. Ejemplo: Bloque 1000, bloque 1001, etc.
- Offset es un desplazamiento dentro de un archivo o volumen. Ejemplo: byte 0, byte 4096, byte 8192, etc.
Ambos representan lo mismo: “donde está el dato”
Ejemplo simple
Imagina un disco como una tabla:
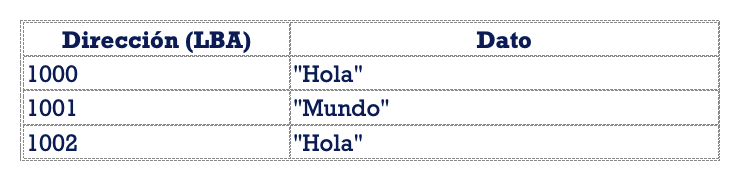
Aquí no hay inteligencia:
- El sistema no sabe que “Hola” esta repetido.
- Solo guarda lo que dices, donde le dices.
Propiedades de este modelo
- Relación 1 a 1: Cada dirección tiene su dato.
- Dependencia física: El dato está ligado a una ubicación específica.
- Escritura destructiva: Si escribes en la misma dirección, por ejemplo LBA 1000 → “Hola” y sobrescribes LBA 1000 “Adiós”. El dato anterior se pierde.
Sin optimización implícita el sistema no:
- Deduplica
- Comprime
- Detecta patrones
Modelo con deduplicación: Hash(contenido) → Dato
En almacenamiento tradicional se tenía:
Dirección → Dato
Con deduplicación:
Hash(contenido) → Dato
Dirección → referencia al hash
En Hash(contenido) → Dato
Significa que el sistema no utiliza la dirección física (LBA Logical Block Address) para identificar datos, sino una “huella digital” matmética del contenido.
- El sistema guarda cada bloque único una solo vez.
- El hash actúa como identififcador único del contenido
Ejemplo:
Hash("AAAA") → H1 → guarda "AAAA"
Se produce un valor único (o casi único) que representa ese contenido.
En Dirección → referencia al hash
La dirección lógica (LBA, offset, archivo, bloque lógico) ya no apunta al dato directamente, sino que apunta a una referencia (puntero) al hash.
La dirección lógica no contiene el dato.
La dirección contiene el puntero.
Ese puntero apunta a un hash.
El hash es el que finalmente lleva al dato físico.
Ejemplo:
Entrada:
Archivo: ["AAAA", "BBBB", "AAAA"]
Cálculo de hash:
"AAAA" → H1
"BBBB" → H2
"AAAA" → H1
Almacenamiento físico:
H1 → "AAAA"
H2 → "BBBB"
Nota: Solo se guarda una vez cada contenido.
Mapeo lógico:
Dirección 0 → H1
Dirección 1 → H2
Dirección 2 → H1
Nota: La dirección ya no apunta al dato, apunta a una identidad del dato (hash).
Thin provisioning
Es una técnica de asignación lógica de almacenamiento bajo demanda.
Ejemplo sin deduplicación
Tienes un almacenamiento con 10 TB físicos.
Creas 3 volúmenes:
- Volumen A: 5 TB
- Volumen B: 5 TB
- Volumen C: 5 TB
Total lógico: 15 TB
Total físico: 10 TB
Esto es posible porque no se utiliza todo al mismo tiempo. Si no escribes no ocupa disco.
Thin provisioning + Deduplicación
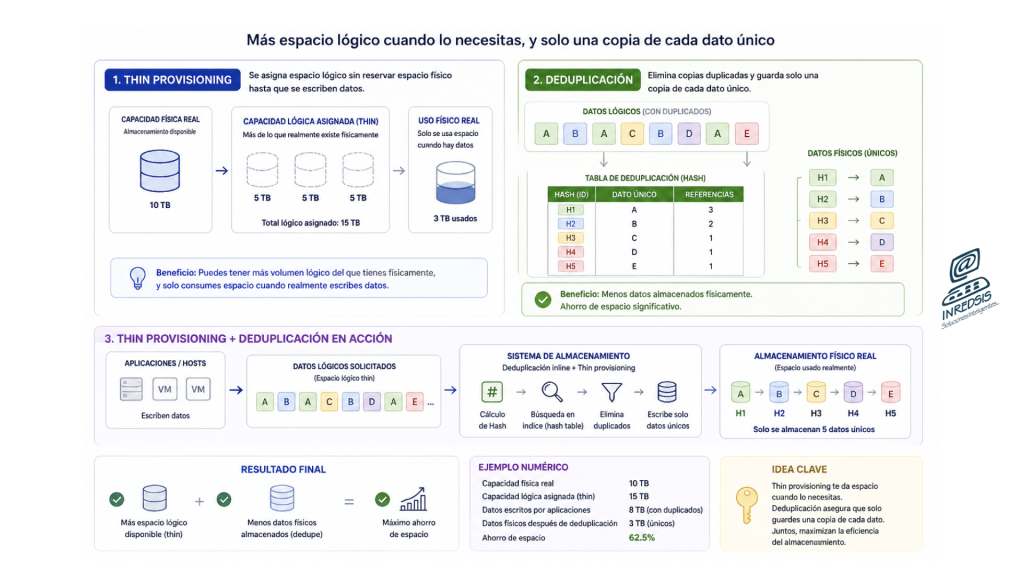
Diferencia clave
Ejemplo combinado
Escenario:
3 máquinas virtuales iguales:
VM1 → 100 GB
VM2 → 100 GB
VM3 → 100 GB
Sin optimización:
Total físico = 300 GB
Con Thin Provisionig:
(Si solo utilizan 50 GB cada una)
Total físico = 150 GB
Con deduplicación:
(Si comparten el mismo Sistema Operativo)
Total físico ≈ 50–70 GB
Con ambos:
Thin + Dedupe = máximo ahorro
Ventajas combinadas
Máxima eficiencia
- Menos discos necesarios
- Mejor ROI
Ideal para:
- Virtualización (VMware, Proxmox)
- VDI
- Backups
- Bases de datos repetitivas.